디퓨전 모델Diffusion Model · 확산 모델
잡음(지지직 화면)에서 시작해 조금씩 잡음을 걷어 내며 그림을 만들어 내는 생성 AI 방식이에요.
쉽게 말하면
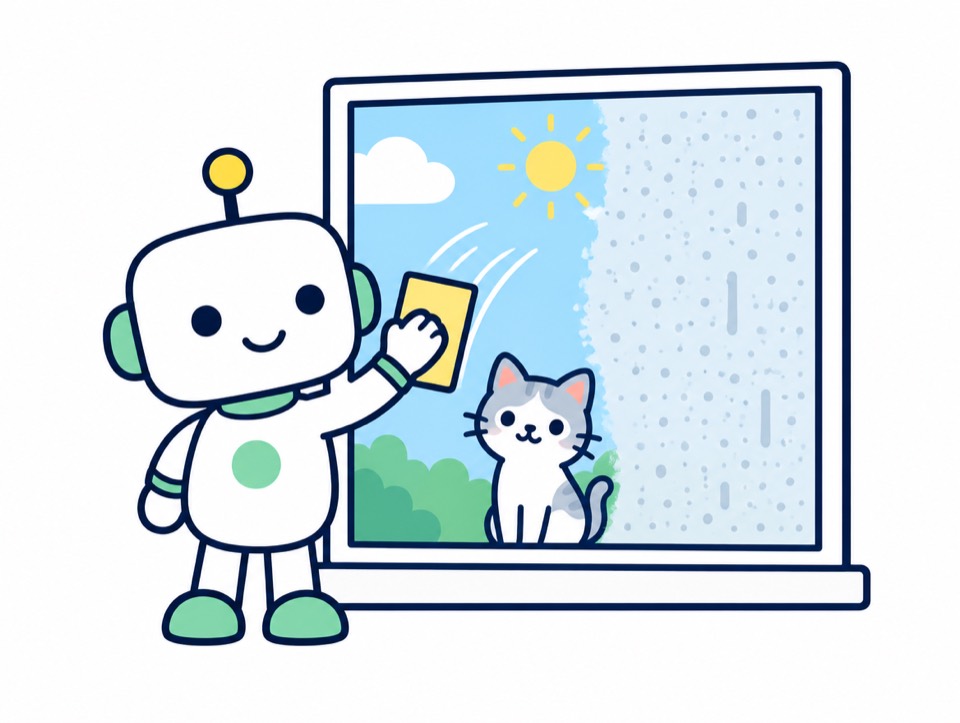
뿌옇게 김 서린 유리창을 닦아 가며 그 뒤의 풍경을 드러내는 걸 떠올려 보세요.
디퓨전 모델은 처음에 완전히 지지직거리는 화면에서 시작해서, '고양이'라는 말에 맞게 잡음을 조금씩 닦아 내요.
수십 번 닦아 내면 어느새 선명한 고양이 그림이 나타나요.
그림으로 정리하면
잡음을 조금씩 걷어 내요
잡음지지직 화면
조금 닦기윤곽이 보여요
더 닦기고양이 모양
완성선명한 고양이
배울 때와 만들 때는 방향이 거꾸로예요
배울 때
- 멀쩡한 그림에서 시작해요
- 잡음을 조금씩 섞어요
- 잡음을 걷는 법을 익혀요
만들 때
- 잡음에서 시작해요
- 글에 맞게 잡음을 걷어 내요
- 새 그림이 나타나요
실제로는
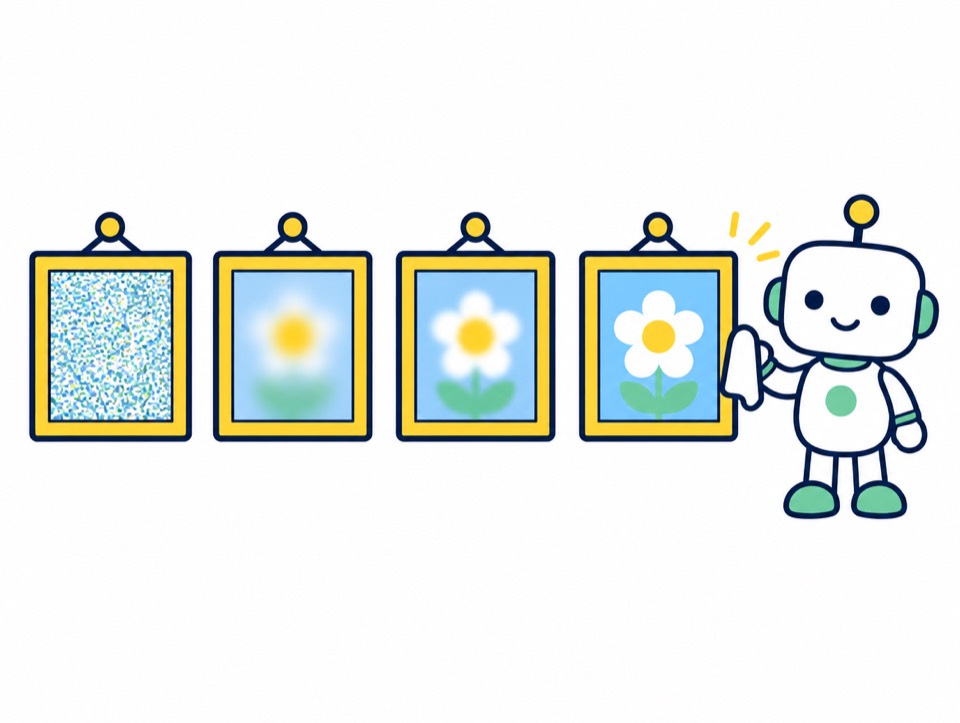
- 배울 때는 거꾸로, 멀쩡한 그림에 잡음을 조금씩 섞어 가며 '잡음을 걷어 내는 법'을 익혀요.
- Stable Diffusion 같은 이미지 생성 AI와 많은 영상 생성 AI가 이 방식을 써요.
- 글을 만드는 LLM과는 만드는 방식이 달라요. LLM은 다음 토큰을 하나씩 붙여요.
왜 알아야 하나요
이미지 AI에 '단계 수(steps)'나 '시드(seed)' 같은 설정이 왜 있는지 이해할 수 있어요. 몇 번 닦을지, 어떤 잡음에서 시작할지예요.
헷갈리기 쉬운 것
- 같은 문장으로도 시작 잡음이 다르면 다른 그림이 나와요.
- 그림 속 글자나 손가락이 이상하게 나오는 일이 아직 있어요.