강화학습Reinforcement Learning
해 보고, 잘하면 점수(보상)를 받고 못하면 깎이면서, 점수를 가장 많이 받는 방법을 스스로 찾는 학습이에요.
쉽게 말하면
강아지에게 '앉아'를 가르칠 때, 앉으면 간식을 줘요. 강아지는 간식을 받으려고 앉는 법을 익혀요.
강화학습도 정답을 알려 주지 않아요. 대신 해 본 결과에 점수를 줘요.
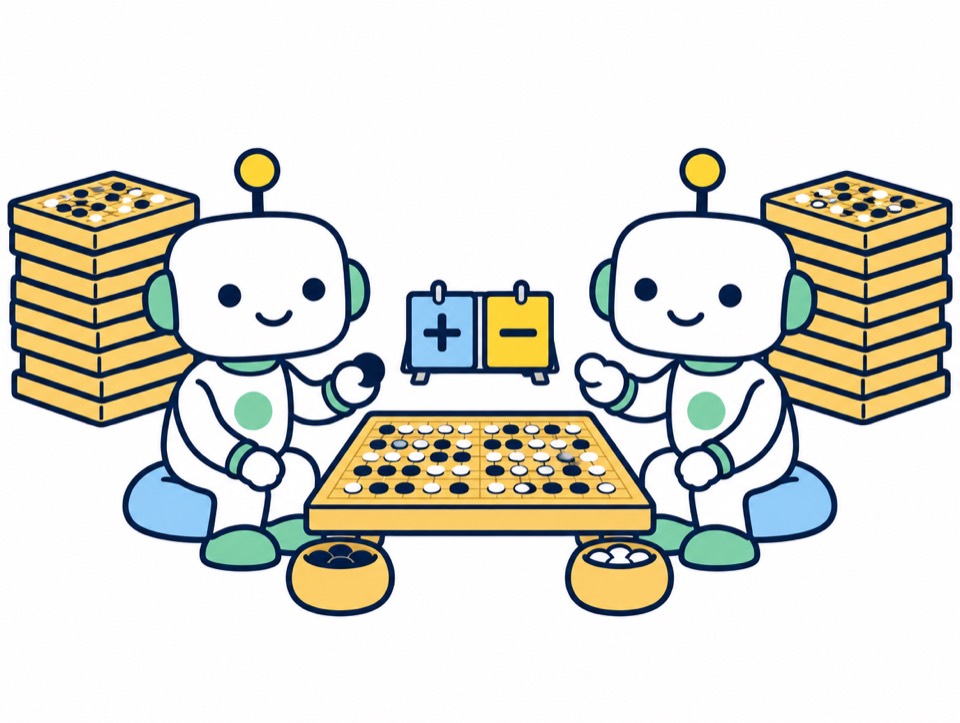
AI는 수많은 시도 끝에 점수가 높아지는 행동을 골라요. 바둑 AI 알파고도 이렇게 실력을 키웠어요.
그림으로 정리하면
해 보고 → 점수 받고 → 고치기
- 해 봐요바둑돌을 한 수 둬요
- 점수를 받아요이기면 +1, 지면 -1
- 점수가 오르는 쪽으로 고쳐요다음엔 더 좋은 수를 골라요
- 수백만 판 반복사람보다 잘 두게 돼요
정답을 알려 주나, 점수만 주나
지도학습
- '이 수가 정답이야'
- 정답 예시가 필요해요
- 사진 분류, 스팸 거르기
강화학습
- '이겼으니 +1점'
- 결과 점수만 있으면 돼요
- 게임, 바둑, 로봇, 추론 모델
실제로는
- 게임, 로봇 움직임, 자율주행 연습에 많이 써요.
- ChatGPT 같은 언어 모델도 사람의 평가를 점수로 바꿔 강화학습을 해요(RLHF).
- 요즘 '추론 모델'은 문제를 맞히면 점수를 받는 강화학습으로 차근차근 생각하는 법을 길러요.
왜 알아야 하나요
AI가 왜 사람이 좋아하는 말투로 답하는지, 왜 가끔 '듣기 좋은 말'을 하는지 이해할 수 있어요. 점수를 받는 쪽으로 배웠기 때문이에요.
헷갈리기 쉬운 것
- 점수 기준이 잘못되면 AI가 '점수만 따는 꼼수'를 배울 수 있어요.
- 정답 카드로 배우는 지도학습과 달리, 결과 점수로 배워요.