RLHFReinforcement Learning from Human Feedback · 사람 피드백 강화학습
사람이 AI의 답 중 더 나은 것을 고르면, 그 취향을 점수로 바꿔 AI를 강화학습시키는 방법이에요.
쉽게 말하면
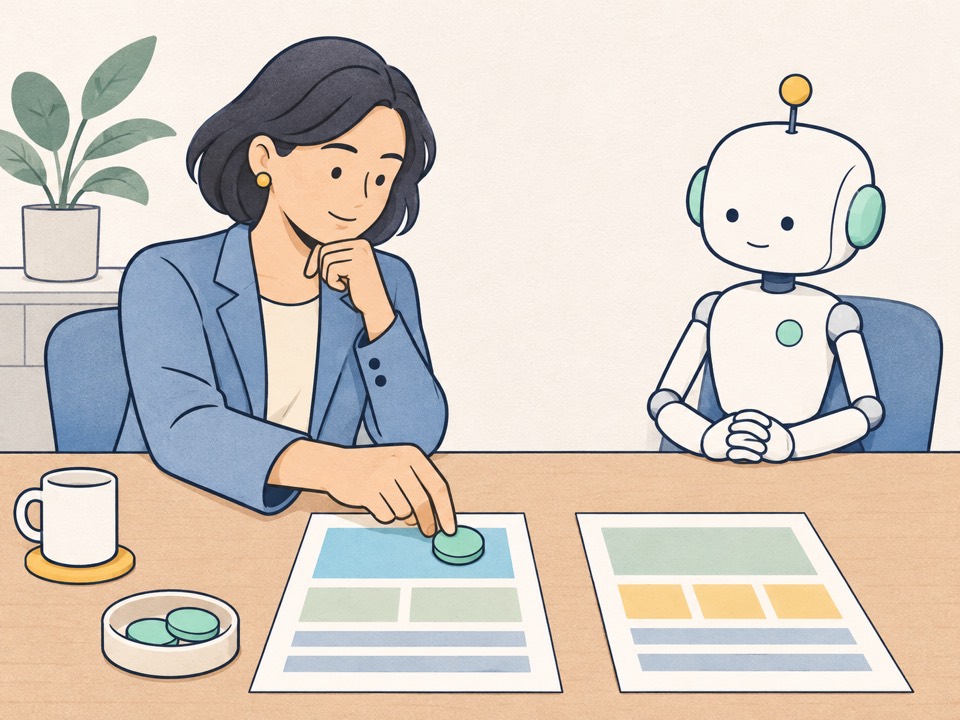
글짓기 대회에서 심사위원이 두 글을 보고 '이게 더 좋아' 하고 골라 준다고 해 봐요.
이렇게 고른 결과를 잔뜩 모아 '좋은 답 점수기'를 만들어요.
그다음 AI가 답을 쓸 때마다 점수기로 점수를 매기고, 점수가 높아지는 쪽으로 AI를 고쳐요.
그림으로 정리하면
RLHF가 돌아가는 순서
- 답 두 개 쓰기같은 질문에 AI가 답 A, B를 써요
- 사람이 고르기'A가 더 좋아요'
- 점수기 만들기고른 결과를 모아 보상 모델을 학습
- 점수 오르는 쪽으로AI를 강화학습으로 고쳐요
다듬기 전과 후
다듬기 전 (베이스 모델)
- 질문에 이어 쓰기만 해요
- 엉뚱한 방향으로 흘러가요
- 말투가 들쭉날쭉해요
RLHF 후
- 질문에 맞춰 답해요
- 공손하고 정리된 말투
- 위험한 요청은 거절해요
실제로는
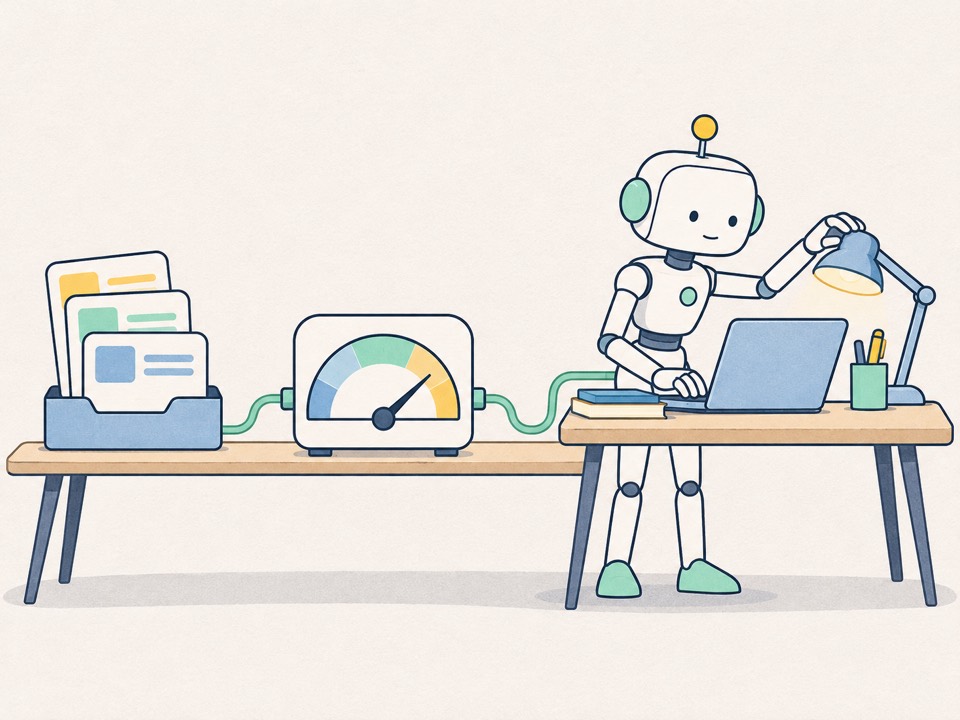
- 사람이 고른 결과로 보상 모델(점수기)을 먼저 학습시키고, 그 점수로 LLM을 강화학습해요.
- ChatGPT가 공손하고 도움이 되게 답하는 데 큰 역할을 했어요.
- 요즘은 사람 대신 AI가 평가하는 방법(RLAIF)이나 규칙 문서(헌법)로 평가하는 방법도 함께 써요.
왜 알아야 하나요
AI가 왜 듣기 좋은 말을 하거나 지나치게 맞장구를 치는지 이해할 수 있어요. 사람이 좋아하는 답 쪽으로 배웠기 때문이에요.
헷갈리기 쉬운 것
- 사람이 좋아하는 답 ≠ 정확한 답이에요. 그럴듯하게 자신 있게 말하는 쪽으로 기울 수 있어요.
- 평가하는 사람의 생각이 치우치면 AI도 치우쳐요(편향).